embedding access的前置知识
问题
互联网客户会有大量并发请求,embedding access 有没有可以共享、重排、聚合、复用的结构?搜广推的很多模型memory lookup怎样利用GPU的存储计算结构实现优化?
基础知识
embedding access
【科普】大家一直说的Embedding(嵌入)是什么?,一文看懂!-CSDN博客 把文本图像等元素转成表达语义的浮点数向量,向量距离表示元素间语义相似程度。 运行过程中,根据一批 ID 去一张很大的 embedding table 里把对应的向量读出来。 把所有向量排起来:
Embedding Table

ID       Embedding

0    →   [ ............ ]
1    →   [ ............ ]
2    →   [ ............ ]
...
42   →   [ ............ ]
...
数学上,它就是一个巨大的矩阵: 其中 NN 是 ID 数量,DD 是 embedding dimension。 比如 1 亿个商品,每个商品 128 维,每个元素 FP32,那么单张表就是:108×128×4 bytes≈51.2 GB
- 特点:访问通常不连续
- VS矩阵乘访问:规则、连续、可分块
示例
是不是类似页表中一样的拿index去页表里查找对应的mem块,然后替换的策略这种类似LRU复用可以提升。 假设有三个请求,串行进行需要反复读很多向量
Request A:
[17, 42, 100, 200]
Request B:
[17, 51, 100, 300]
Request C:
[17, 42, 100, 500]如果三个请求能够聚合起来:[17 42 51 100 200 300 500],之lookup一次,那么12 次 embedding access就会变成7 次
重排则是把相近的id尽量一起处理,如[17, 918273, 18, 728193, 19, 20]
- 问题?
- 但是embedding table只是一个应用层的表,还需要经过底层的GPU tlb/cache。就算一起处理id连续的嵌入项,底层物理硬件上也不连续,访存也不会简化
- Ans: 存储结构上会连续的。
- LRU和LFU这种为什么不能解决这个问题
- Ans: LRU、LFU 等是在解决cache 容量有限时,留下谁?而这个embedding access的问题是能不能在这些请求真正发往 GPU memory system 之前,就发现它们存在共同访问?
- GPU的特点
- Ans: SIMT(单指令多线程),warp同一条访问
x = embedding[id];的各个线程可以id不同
- Ans: SIMT(单指令多线程),warp同一条访问
- 聚合发生在 load 指令之前还是之后?
- Ans: GPU 自己做的 hardware coalescing在 load 指令之后,硬件拿到各 lane 的地址以后,再把这些地址合并为 transaction。
- software aggregation / reordering是在真正执行 embedding load 之前,先改变 workload。
- 某个 warp 运行到一条load指令时threads产生的不同地址会由硬件统一coalescing,而软件会重排这些load的顺序和聚合
- 但是embedding table只是一个应用层的表,还需要经过底层的GPU tlb/cache。就算一起处理id连续的嵌入项,底层物理硬件上也不连续,访存也不会简化
搜广推模型
搜广推”,是互联网大厂里很常见的缩写,指三类业务:
- 搜:搜索 Search
- 广:广告 Advertising
- 推:推荐 Recommendation
通过搜索词给出搜索结果,搜索结果需要尽量的接近,模型需要预测 。 即输入dense和sparse特征,sparse的特征在embedding table里做memory lookup,然后送入MLP后再排名。 经典模型:
- DLRM:Deep Learning Recommendation Model
- Wide & Deep: Deep部分使用embedding
- DeepFM:解决 feature interaction
Dense feature 和 sparse feature 到底是什么
Dense feature 是本身就能直接作为数值参与计算的特征,它们进模型以后通常形成一个正常的小矩阵,然后进行标准的 GEMM / MLP
- 年龄 21
- 商品价格 3999.0
- 观看时长 18.2 s
- 历史点击率 0.13 Sparse feature如user_id = 1738291,数字
1738291本身没有数值意义。所以是通过hash映射到向量表里,sparse feature 的处理首先不是“算”,而是查。
所以一个推荐inference可以写成:请求发送后,稀疏特征进入sparse part(look up 取出向量)然后将向量送入dense part(参与GEMM等)。 其中:
- Sparse part 的典型特点是内存访问密集,少量计算。memory-bound
- Dense part的特点是大量计算,高数据复用 compute-bound
- 概念
- gather:就叫 gather。反过来,把数据根据 index 写回不同位置:通常叫 scatter。
- 随机性:
- ID 随机性决定访问 embedding table 的哪些行
- 请求长度随机性决定不同请求访问的id数量完全不同
- hotness / skew: Embedding ID 的访问通常不是均匀的,可能有热门ID访问频繁,冷门ID访问很少,这可以决定 cache 是否有效。
相关论文
主线应该是 Exact Embedding Lookup,不是 ANN 向量检索
| 优先级 | 论文 | 年份 | 作用 | 链接 |
|---|---|---|---|---|
| 1 | RecD: Deduplication for End-to-End Deep Learning Recommendation Model Training Infrastructure | 2023, MLSys | batch/session 内重复 sparse feature 先 dedup,再通过 inverse map 恢复;最直接对应“共享、复用、减少实际 lookup 次数” | arXiv: 2211.05239 arXiv 2211.05239 |
| 2 | A GPU-specialized Inference Parameter Server for Large-Scale Deep Recommendation Models | 2022, RecSys | inference 前 batch key dedup;GPU embedding cache + CPU DRAM + SSD 分层;正面对应高并发 serving 的 lookup | arXiv: 2210.08804 arXiv 2210.08804 |
| 3 | Pushing the Performance Envelope of DNN-based Recommendation Systems Inference on GPUs | 2024, MICRO | 不消除 lookup,而是优化剩余 lookup:occupancy、software prefetch、L2 pinning,研究 GPU memory latency | arXiv: 2410.22249 arXiv 2410.22249 |
| 4 | UGACHE: A Unified GPU Cache for Embedding-based Deep Learning | 2023, SOSP | multi-GPU unified embedding cache;利用 skew、access affinity、NVLink/NVSwitch 做跨 GPU reuse | 未检索到公开 arXiv;官方代码与论文入口 |
| 5 | OPER: Optimality-Guided Embedding Table Parallelization for Large-scale Recommendation Model | 2024, USENIX ATC | embedding table 的 fine-grained placement/sharding;减少 remote memory access 和跨 GPU 通信;对应“重排” | 未检索到公开 arXiv;USENIX 论文页 |
| 6 | HierarchicalKV: A GPU Hash Table with Cache Semantics for Continuous Online Embedding Storage | 2026 | 把 GPU hash table 直接做成带 eviction/cache semantics 的 lookup backend;支持 HBM/host tiering | arXiv: 2603.17168 arXiv 2603.17168 |
| 7 | HypeReca: Distributed Heterogeneous In-Memory Embedding Database for Training Recommender Models | 2025, USENIX ATC | 把 embedding lookup 抽象为 distributed KV database;GPU+CPU memory、batch pipeline、热点 embedding replication | 未检索到公开 arXiv;USENIX 论文页 |
| 8 | RecShard: Statistical Feature-Based Memory Optimization for Industry-Scale Neural Recommendation | 2022, ASPLOS | 根据 table/row access frequency 做 tiered-memory placement;hot/cold embedding 放到不同 memory tier | arXiv: 2201.10095 arXiv 2201.10095 |
| 9 | BagPipe: Accelerating Deep Recommendation Model Training | 2023, SOSP | 利用 embedding access skew 和 future-batch knowledge 做 cache + prefetch;说明 lookup workload 存在强热点与可复用性 | arXiv: 2202.12429 arXiv 2202.12429 |
| 10 | Software-Hardware Co-design for Fast and Scalable Training of Deep Learning Recommendation Models | 2022, ISCA | row/column/table sharding、software-managed cache、HBM+DDR+SSD、通信拓扑;建立 lookup 的全局系统视角 | arXiv: 2104.05158 arXiv 2104.05158 |
1 RecD
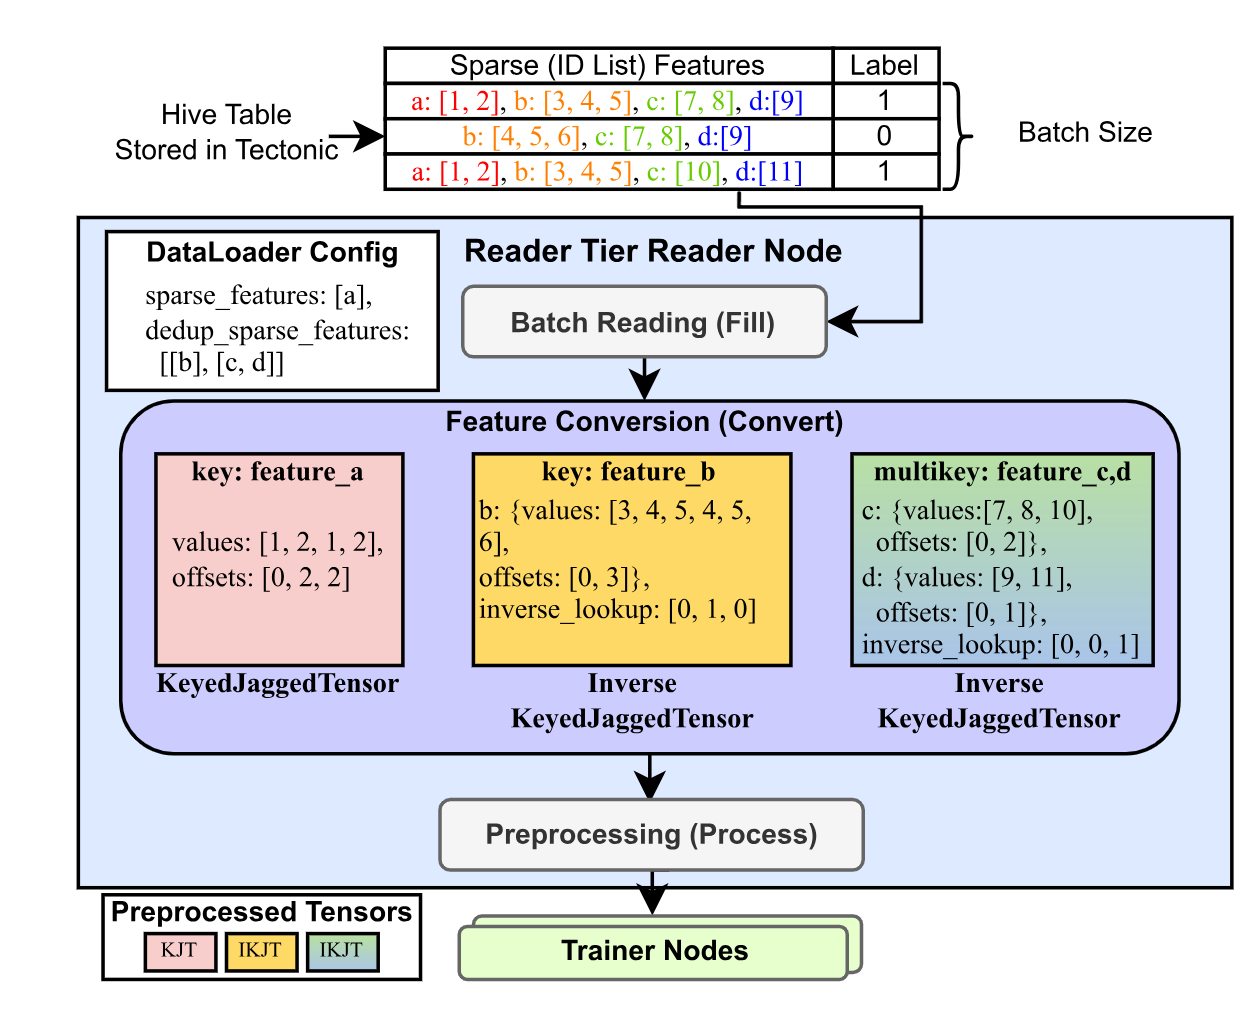
- 普通 PyTorch recommendation pipeline 使用类似 KeyedJaggedTensor,KJT 的结构:将一个键(即特征键)映射到一个 JaggedTensor——一个具有不规则维度的张量,即不同长度的切片。如图中特征a采用KJT格式存储,展开的值是包含重复值的。
- RecD 增加了一个数据结构:Inverse Keyed Jagged Tensor,IKJT 这个结构,不保存每一个列上的特征的值,而换为相同值只保存一次,然后每列保存指向相同值的索引。 并且为了使得更多的特征值相同,按照session ID进行聚类(clustering),session 内按照 timestamp 排序,目的就是让尽量同一batch中的temporal/session locality更大,后面的 dedup 才能看到这些重复
2 A GPU-specialized Inference Parameter Server for Large-Scale Deep Recommendation Models
在大规模的模型推理中,嵌入查找工作负载需要大量 GPU 内存,但计算资源却很少。这种需求不平衡显著偏离了现有硬件,降低了 GPU 在推理系统中的吸引力。因此,大多数现有解决方案将嵌入查找操作与 GPU 中执行的密集计算(即模型的其余部分)解耦,并将其迁移到 CPU,此处反而成了瓶颈:论文明确把 CPU DRAM bandwidth 和 CPU-GPU communication 视为传统架构中的重要瓶颈。 这里考虑SKew
Hierarchical database architecture
这个贡献是用于解决embedding table 太大,GPU 根本装不下这个问题的。论文用三级存储:
- GPU 层保存最频繁使用的 hot embeddings;
- CPU 层保存一部分 embedding,充当 GPU cache 的扩展;
- SSD 层保存完整模型参数,作为最终 backing store。 类似工作集的思想,把 embedding table 本身当成一个具有 working set 的超大地址空间,只把当前 working set 推到 GPU。CPU DRAM 就像 GPU embedding cache 的 第二级软件cache一样。
Inference GPU Embedding Cache
假定第一项已经把 hot embeddings 放 GPU 了。但是GPU HBM 中有几 GB / 几十 GB embeddings,在一定数量的key来的情况下需要快速判断key在不在。所以第二个贡献的本质是 重新设计 lookup data structure,使它符合 GPU SIMT,而不是用unordered_map<Key, Embedding>直接查。
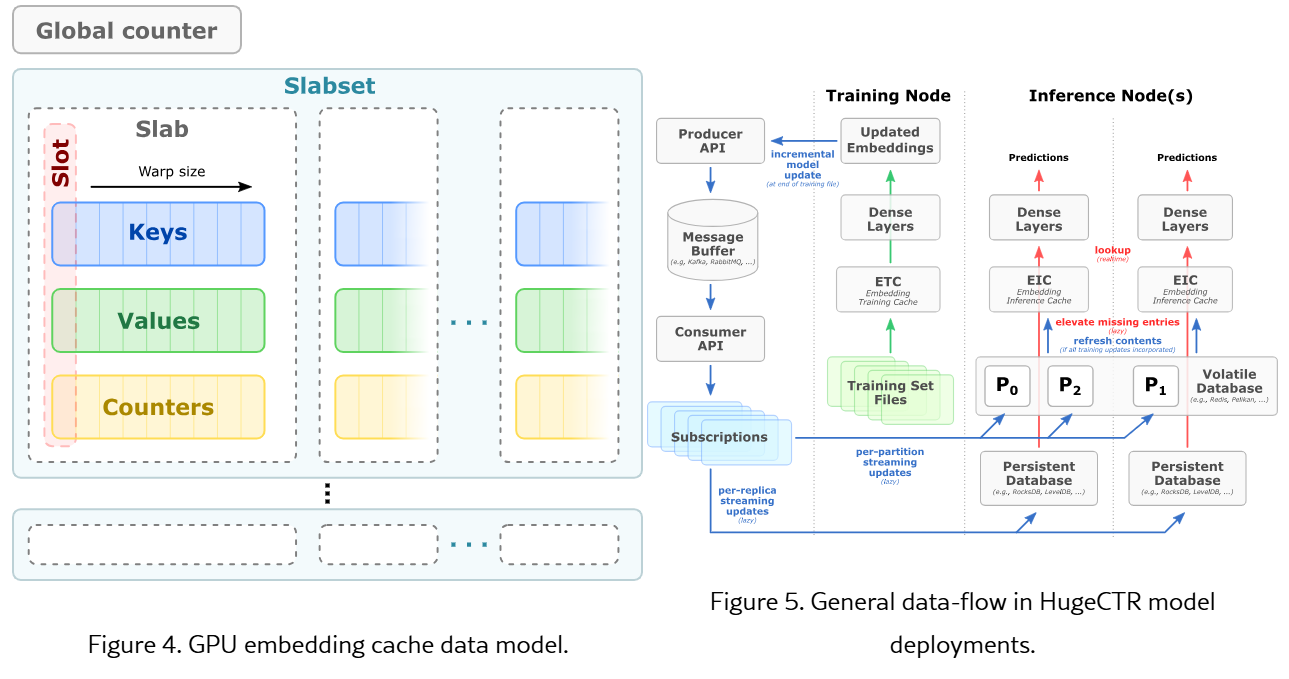
文章中考虑NVIDIA GPU:1 warp=32 threads论文于是规定:1 slab=32 slots,就是为了做到“一线程对应一个 slot”。这样的话每次查询是整个slab一起查询slots中有没有对应的key值,
- 一次并行比较 32 个 entry。
- GPU warp 内部可以使用register-level primitive 来告诉整个 warp某个thread命中了
- 不需要每个线程把状态先写HBM再读回来 然后引出slabset的概念,类似多路组相联,将key值hash之后再分组
3 Pushing the Performance Envelope of DNN-based Recommendation Systems Inference on GPUs
背景为embedding 已经在 GPU HBM 里了,lookup 也确实必须执行,但是还有问题在于memory latency 没有被 GPU 有效隐藏。
把 GPU embedding lookup 为什么慢搞清楚
每一个线程根据id寻找对应行的任务可以写成
//gather + reduce
acc = 0;

for (id : indices) {
    row = embedding_table[id];
    acc += row;
}
这里特别容易卡 memory latency,因为这里存在非常明确的load-use dependency,第六行的add必须等待第5行的ld完成。由于embedding是random access,所以数据大概率不在cache,L1/L2 miss后访问HBM进行查找会产生很大的lantency,整个warp会停下来
- long scoreboard stall
- GPU 正常解决这种问题的方法是这个 warp 等的时候换一个 warp 执行。只要resident warps 足够多,memory latency 就应该被隐藏掉。
- 而PyTorch embedding kernel 的 occupancy 不够论文测到 PyTorch 的 embedding CUDA kernel为74 registers/thread,一个 SM 同时能驻留的 warp 不够。所以会出现所有warp都在等待的时间,lantency就暴露出来了。
OptMT
这个优化点在于控制编译器限制每个thread可用的register。找到一个最优点是的occupancy更高且同时不产生严重的spiling(reg放到mem里)
Software Prefetching + L2 Pinning
在做了OptMT后带宽还是很低,可以发现这个问题其实是memory-lantency bound的
- Prefetching:隐藏 memory latency;
- L2 Cache Pinning:降低 memory latency;
Software Prefetching
类似解决数据冒险一样,在编译水平对指令重排。提前获得未来会需要的E0 E1 E2 E3 的地址,然后提前load这些指令,不与下一条数据相关的指令连续执行可以隐藏掉这个延迟
- embedding 特别适合软件 prefetch
- kernel 开始的时候已经拿到了offset array和 indices array,所以线程其实提前知道下一次embedding access需要什么,不会发生CPU hardware prefetcher 那种“预测错地址”的主要问题。
- embedding access 虽然在物理地址上 irregular,但在软件层面并不是不可预测。 问题:software prefetch 不会减少mem访问量,还会增加额外 instruction。 如果预取过于积极,HBM latency还会增高
L2 Pinning
普通的cache替换策略还是会把cache替换出去。 既然应用层已经知道哪些 embedding 特别 hot,就不要完全让硬件 replacement policy 自己猜。直接将top hot embedding rows pin to L2。 而定义hot的方式又是使用offline profiling。
- 具体的实现方法不是永远不能eviction,ers而是改变 eviction priority
6 HierarchicalKV: A GPU Hash Table with Cache Semantics for Continuous Online Embedding Storage
以前的 GPU hash table 被当成 dictionary;HKV 认为在线 embedding storage 更应该被当成 cache。 传统字典语义要求“插进去的 key 必须一直存在”,所以表快满的时候只能越来越长地 probe,最后 rehash 或 insert failure;HKV 直接改变这个契约:表满是正常状态,新 embedding 到来时直接在 GPU hash table 内部决定“淘汰旧 entry”还是“拒绝新 entry”。论文明确把这种 full-capacity 下仍持续运行定义为 cache semantics。
Single-Bucket-Confined Cache-Line-Aligned Design
当 load factor:越来越接近1.0,空 slot 越来越少,于是 miss 需要越来越多 probes。这会使得不同 thread 工作量不一样(warp divergence)
- HKV 的做法非常激进:一个 key 只能待在一个 bucket
- 也就是不存在hash溢出后的额外块,检查完hash后的桶就可以确定miss
- 每个 key 除了完整的
uint64 key还存一个8-bit digest(hash fingerprint),于是一个 bucket 有:128×1B=128B,而 NVIDIA GPU 的 L1 cache line 正好是128B,于是: 128 个候选key的fingerprint=1 条GPUL1cacheline
Score-Driven Built-in Eviction
传统 dictionary 不允许随便扔旧 key,因此只能继续 probe或者 rehash。但是 HKV 已经接受 cache semantics,所以可以类似cache替换,找到最没有价值的那个直接换掉。
- 在slot中增加一个score字段
- 比较新key和min(score)
- 留下这两个中score更高的
Score-Based Dynamic Dual-Bucket Selection
因为每个桶的利用率不同,所以虽然整个 hash table 还远没满,但 A 因为 hash collision 已经开始 eviction。 所以每个 key 给两个 candidate buckets,也就是经典 P2C(Power of Two Choices,二选一负载均衡):选更空的 bucket 而两个桶容量都满了之后,就可以改为Score-Based 的evict方法
什么叫HBM+HMEM
假设:
key = 12345
embedding E12345 = [0.1, 0.7, ..., -0.3]
score = 9821
HKV 把它拆成两部分:
索引/元数据:
key = 12345
digest
score

数据:
value = E12345
然后它规定:
key / digest / score
永远在 GPU HBM

embedding value E
可以在:
   GPU HBM
或者
Host Memory (HMEM)- 如果这个miss了,lookup(key=12345)整个 bucket 都没有 12345,直接返回
NotFound。 - 论文自己在讨论 eviction 时就说,错误地 evict 一个热门 embedding 会导致: costly recomputation or a remote fetch